
企业或用户把 OA、API、服务器等系统和设备通过内网穿透映射到公网,调试阶段能正常访问后,后续几乎很少再关注应用状态。内网服务能不能用、正不正常,往往只能通过 SSH 登录服务器手动查看。
由于内网应用状态不可知,一旦访问异常,只能被动等待用户反馈"应用不能访问、服务器连不上",而这个空窗往往已经持续了较长时间,业务受到明显影响。对企业和团队的核心业务来说,这种被动发现难以接受。
01.真正的盲区:隧道通了,不代表应用活着
内网穿透解决的是"公网能不能连到隧道入口",并不保证入口背后的内网应用真的在正常响应。
一个容易被忽略的事实是:客户端在线、隧道连通,都只能说明通道本身是通的,不能证明应用进程健康。端口写错、进程没启动、服务 OOM 被 Kill、健康接口报错,这些问题在公网侧表现可能只是"打不开"或"超时",而在管理员主动登录之前,系统自己不会说话。
于是故障发现的顺序变成了:用户先遇到问题 → 反馈给业务侧 → 再转到运维排查。发现时点被大幅推迟,正是"被动报障"成本高的根源。
02.ZeroNews 隧道应用探测是什么
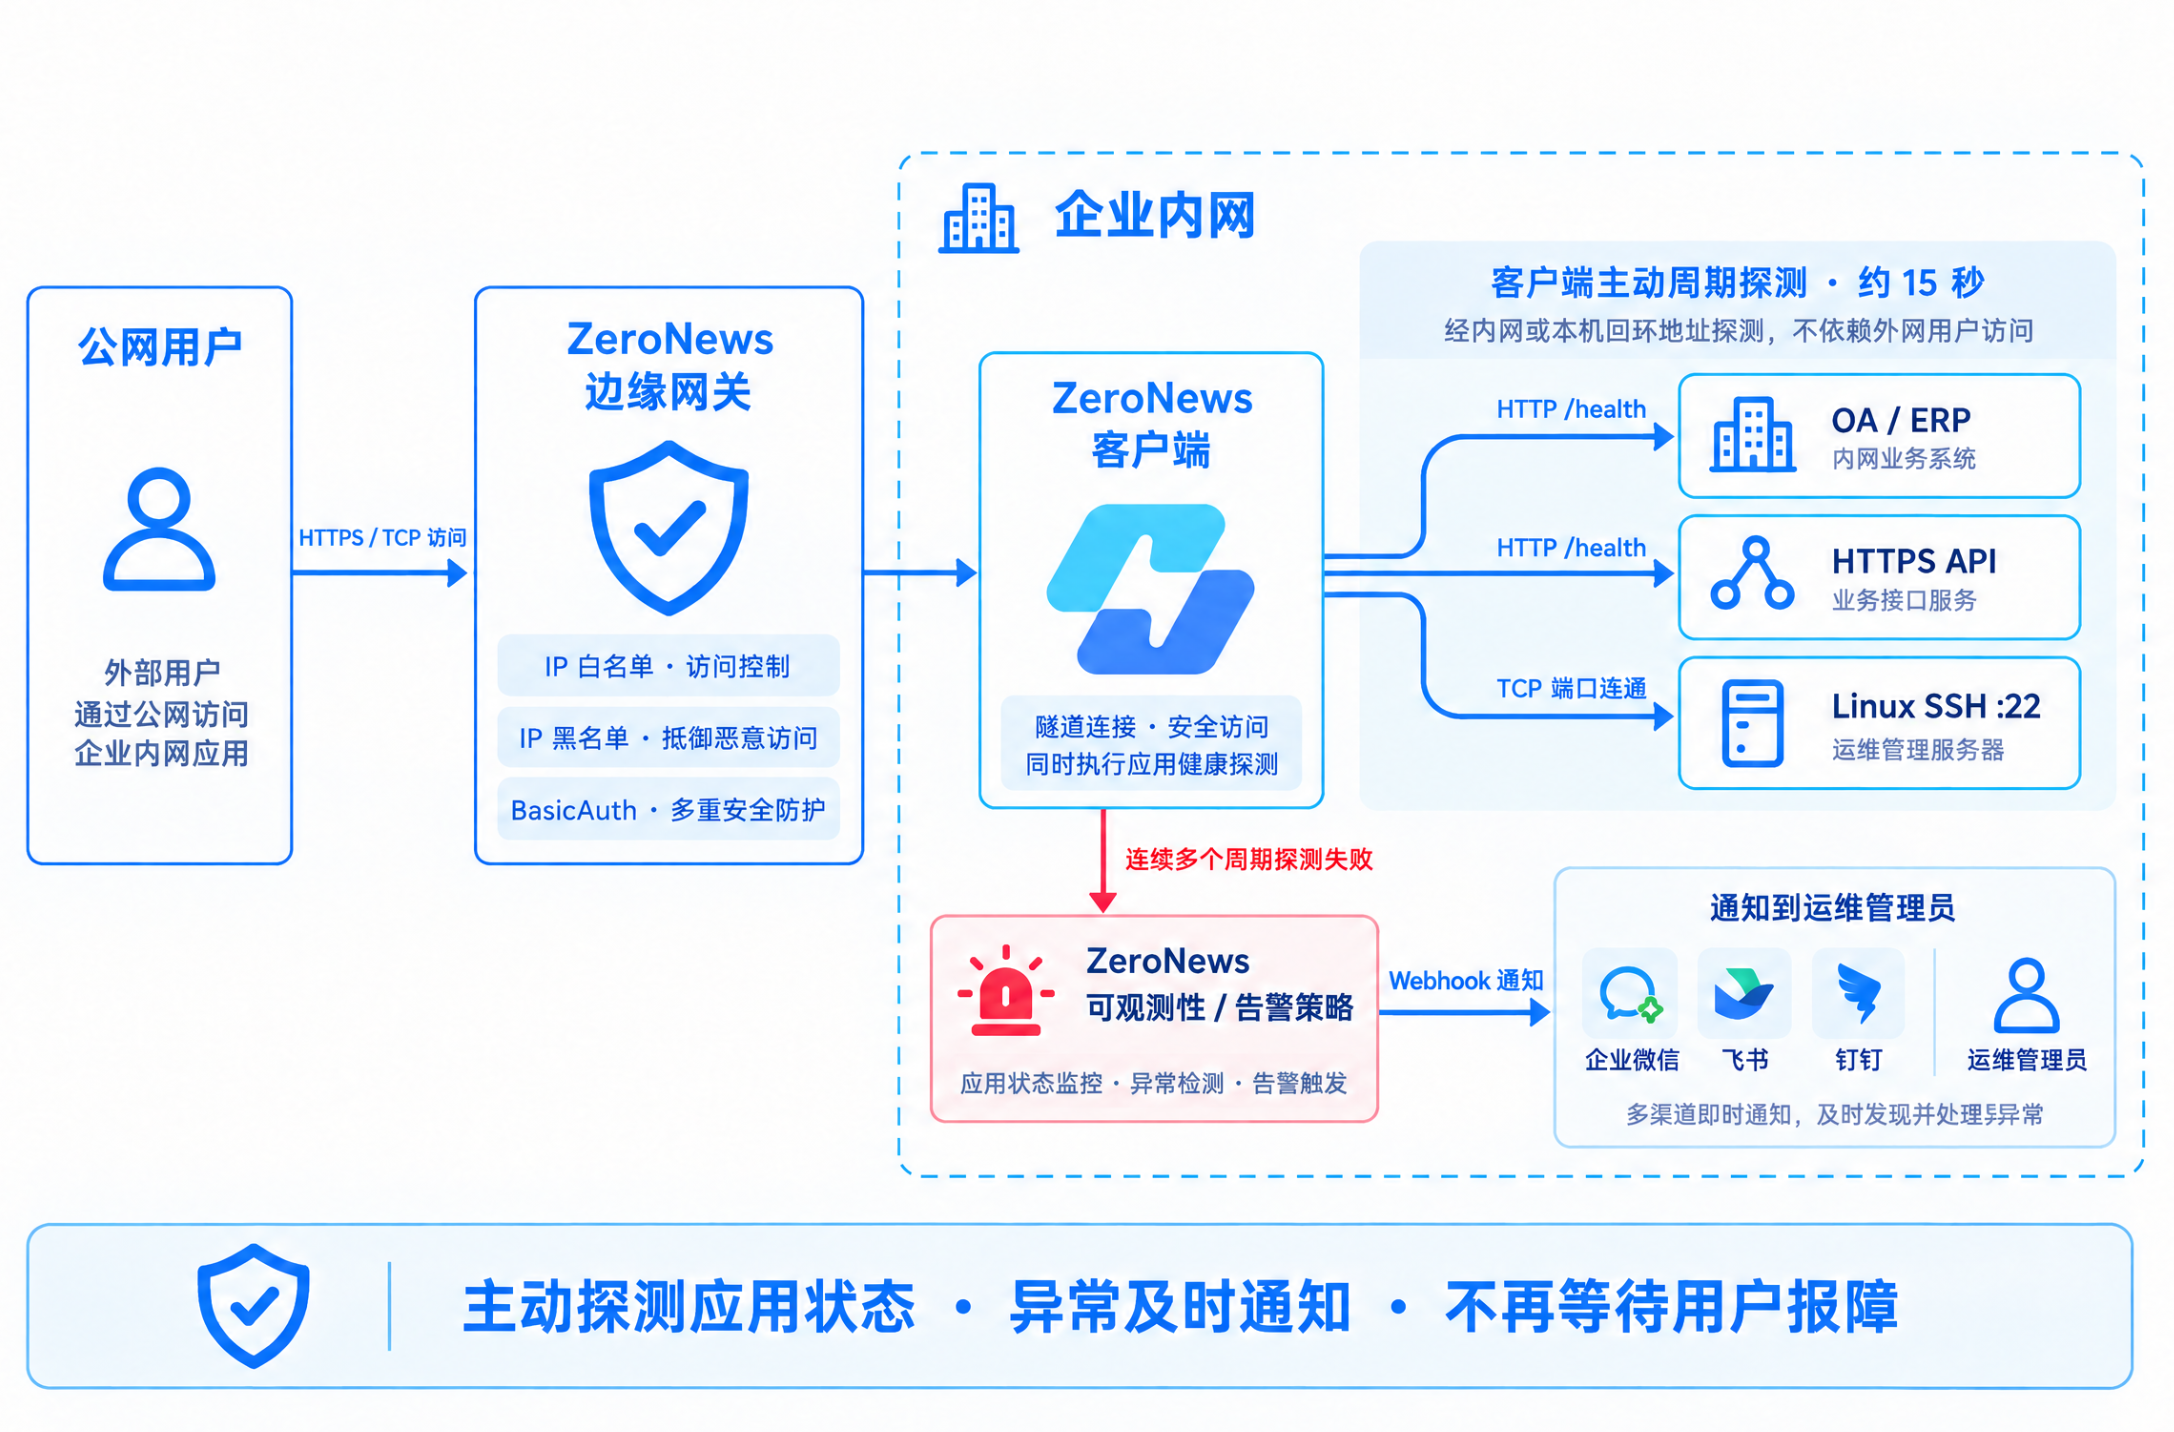
ZeroNews 的隧道应用探测,解决的正是"内网应用状态不可知"这个问题。 简单说,它由客户端对内网应用周期性发起 HTTP/TCP 探测连接;当连续几个周期都收不到内网应用的探测响应,就判定服务异常,再结合告警通知,在检测到异常的第一时间通过企微、飞书、钉钉自动通知运维管理员,让管理员主动知道故障发生,而不是被动等待。
💡关键区别:探测请求由客户端发起,经内网或本机回环地址直达内网应用,不依赖外网用户先访问。即使暂时没有公网流量,应用异常也能被及时感知。
- HTTPS 类隧道:需要配置一个可探测的 URL 路径(例如 /health、/api/status),通过该路径的响应判断应用是否正常。
- TCP 类隧道:以端口 TCP 连通性判断本地服务是否在监听,无需配置 URL
03.四个特性:为什么它能比用户更早发现故障
① 客户端发起,贴近真实转发路径。探测请求从客户端发往本机映射端口,与 ZeroNews 转发流量所经路径一致。正因为走的是同一条路,端口写错、进程未启动这类问题更容易在早期被暴露,而不是等到公网访问失败才回头排查。
② 按隧道独立配置,互不牵连。每条映射都可以有自己的探测地址和告警开关。OA 与对外 API 分隧道维护时,一条业务重启,不会影响另一条的探测策略。
③ 秒级自动检测,异常发现快。客户端以 15 秒为间隔持续探测内网应用,探测请求经内网转发、没有公网延时,应用异常可被立即感知。
④ 异常联动 Webhook 告警。把应用探测与告警通知结合:一旦判定异常,第一时间通过企微、飞书、钉钉推送给负责人,由系统主动找人,而不是等人来报。
04.三个典型场景:故障分别藏在哪里
对外 HTTPS API:接口超时、502、个别路由 5xx
对外提供的 HTTPS API,合作方或移动端调用时出现超时、502,或者个别路由一直返回 5xx。系统同事的第一反应常常是"隧道是不是断了":先查客户端是否运行、是否在线,再去检测 API 服务。实际原因可能是 upstream 进程挂了、端口没监听,也可能是健康路径或核心接口故障,都需要一步步排查定位。
给这条 API 隧道配置 /health 或固定探测路径,由客户端在本机周期性发起探测,并通过 Webhook 推送到企微、飞书、钉钉,就能在第一时间知道并及时处理 API 异常,而不是等合作方先找上门。
企业 OA / ERP:访问异常,第一时间感知
不少企业用容器跑 OA、ERP 等核心业务。资源配额紧张、访问量一上去,就容易 OOM 内存不足,进程被系统 Kill;或者宿主机异常连带应用起不来,导致服务无法正常启动。这类问题往往要等用户反馈访问不了才被发现,而此时服务可能已经挂了很久。
为 OA/ERP 隧道配置应用探测(健康路径或约定 URL),检测到异常即通过 Webhook 推送。运维能在访问异常的第一时间知道应用已故障,而不是被动等业务侧大面积反馈才发现 OA/ERP 不可用。
SSH 远程 TCP 隧道:服务器宕机,无法及时感知
很多团队把 Linux 服务器通过 TCP 隧道映射到公网做远程运维:隧道和域名都配好了,客户端也显示在线。一旦机器宕机、重启后 sshd 没起来,或者内核异常、磁盘打满导致 SSH 服务挂掉,外网表现就是一直连不上,中间空窗可能很长。
为 SSH 隧道开启 TCP 连通类探测,由客户端周期性检测内网服务器的 SSH 端口(默认 22,或实际使用的端口)能否正常连接;连续多个周期探测失败即触发 Webhook 告警。运维能在服务器故障的第一时间收到通知,再安排重启、进机房或走带外管理,而不是等所有人都连不上才被动排查。
05.如何在 ZeroNews 上配置应用探测与告警
- HTTPS 隧道:配置健康检查路径
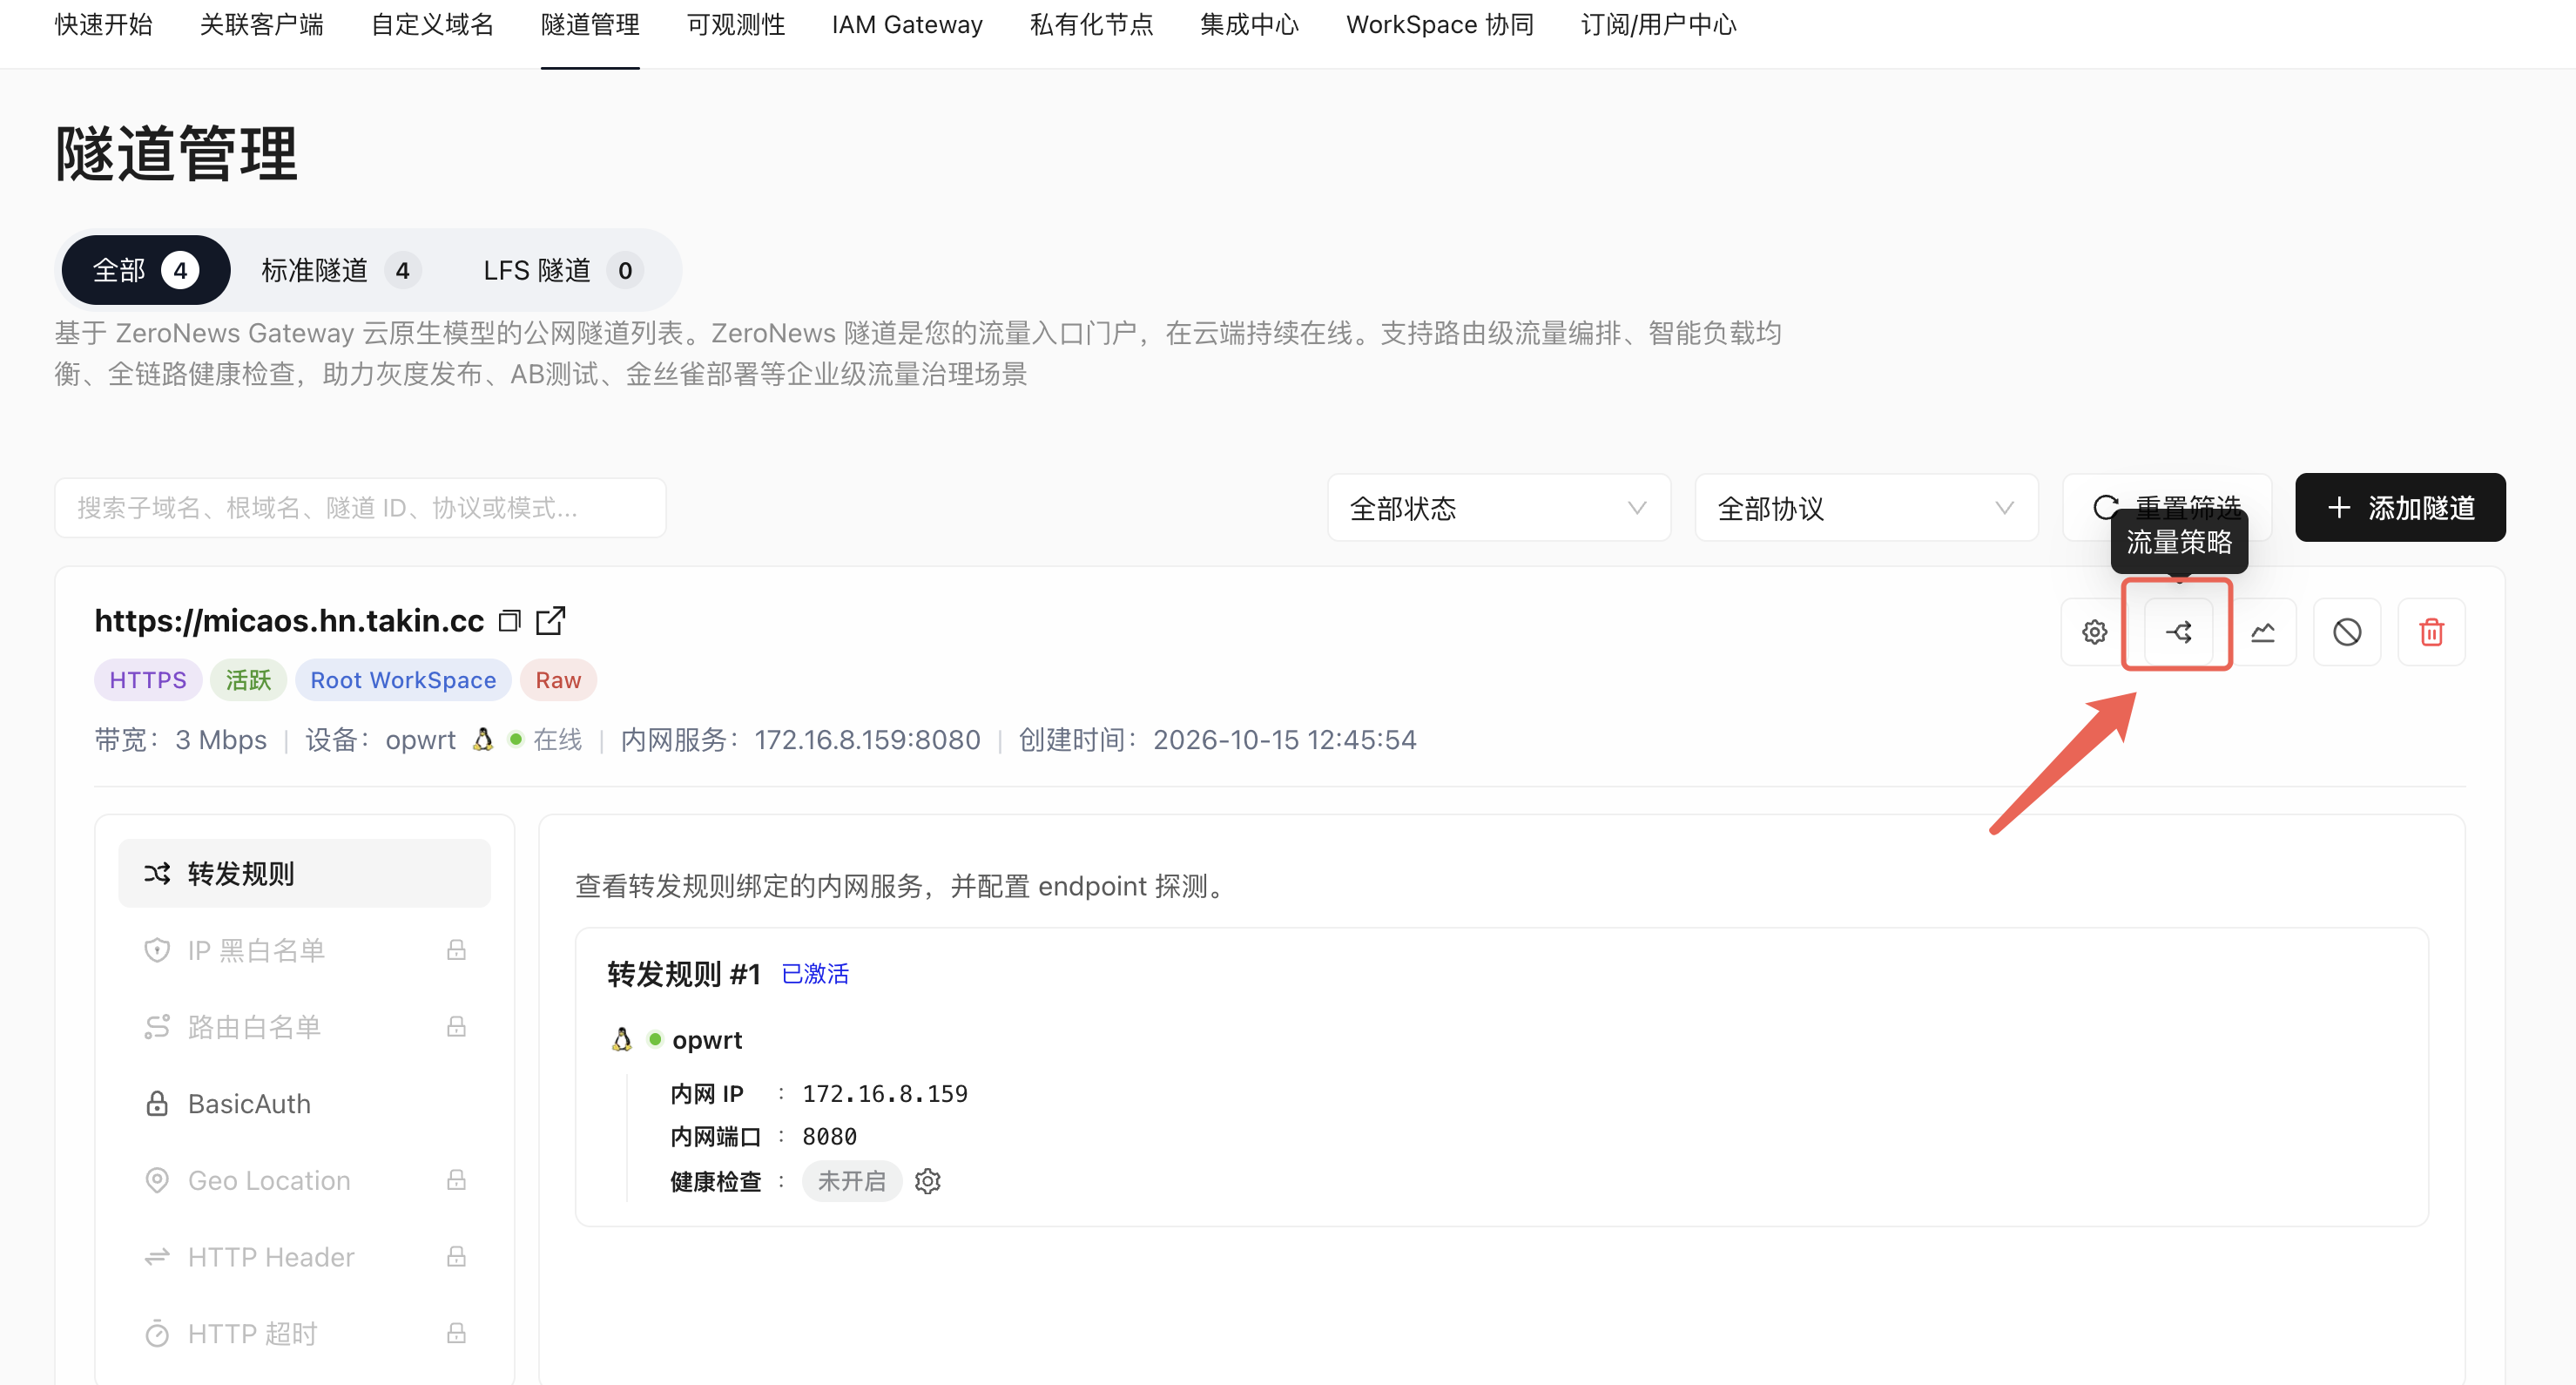
在ZeroNews控制台的「隧道管理」页面,点击需要配置应用探测的 HTTPS 隧道后方的流量策略图标。
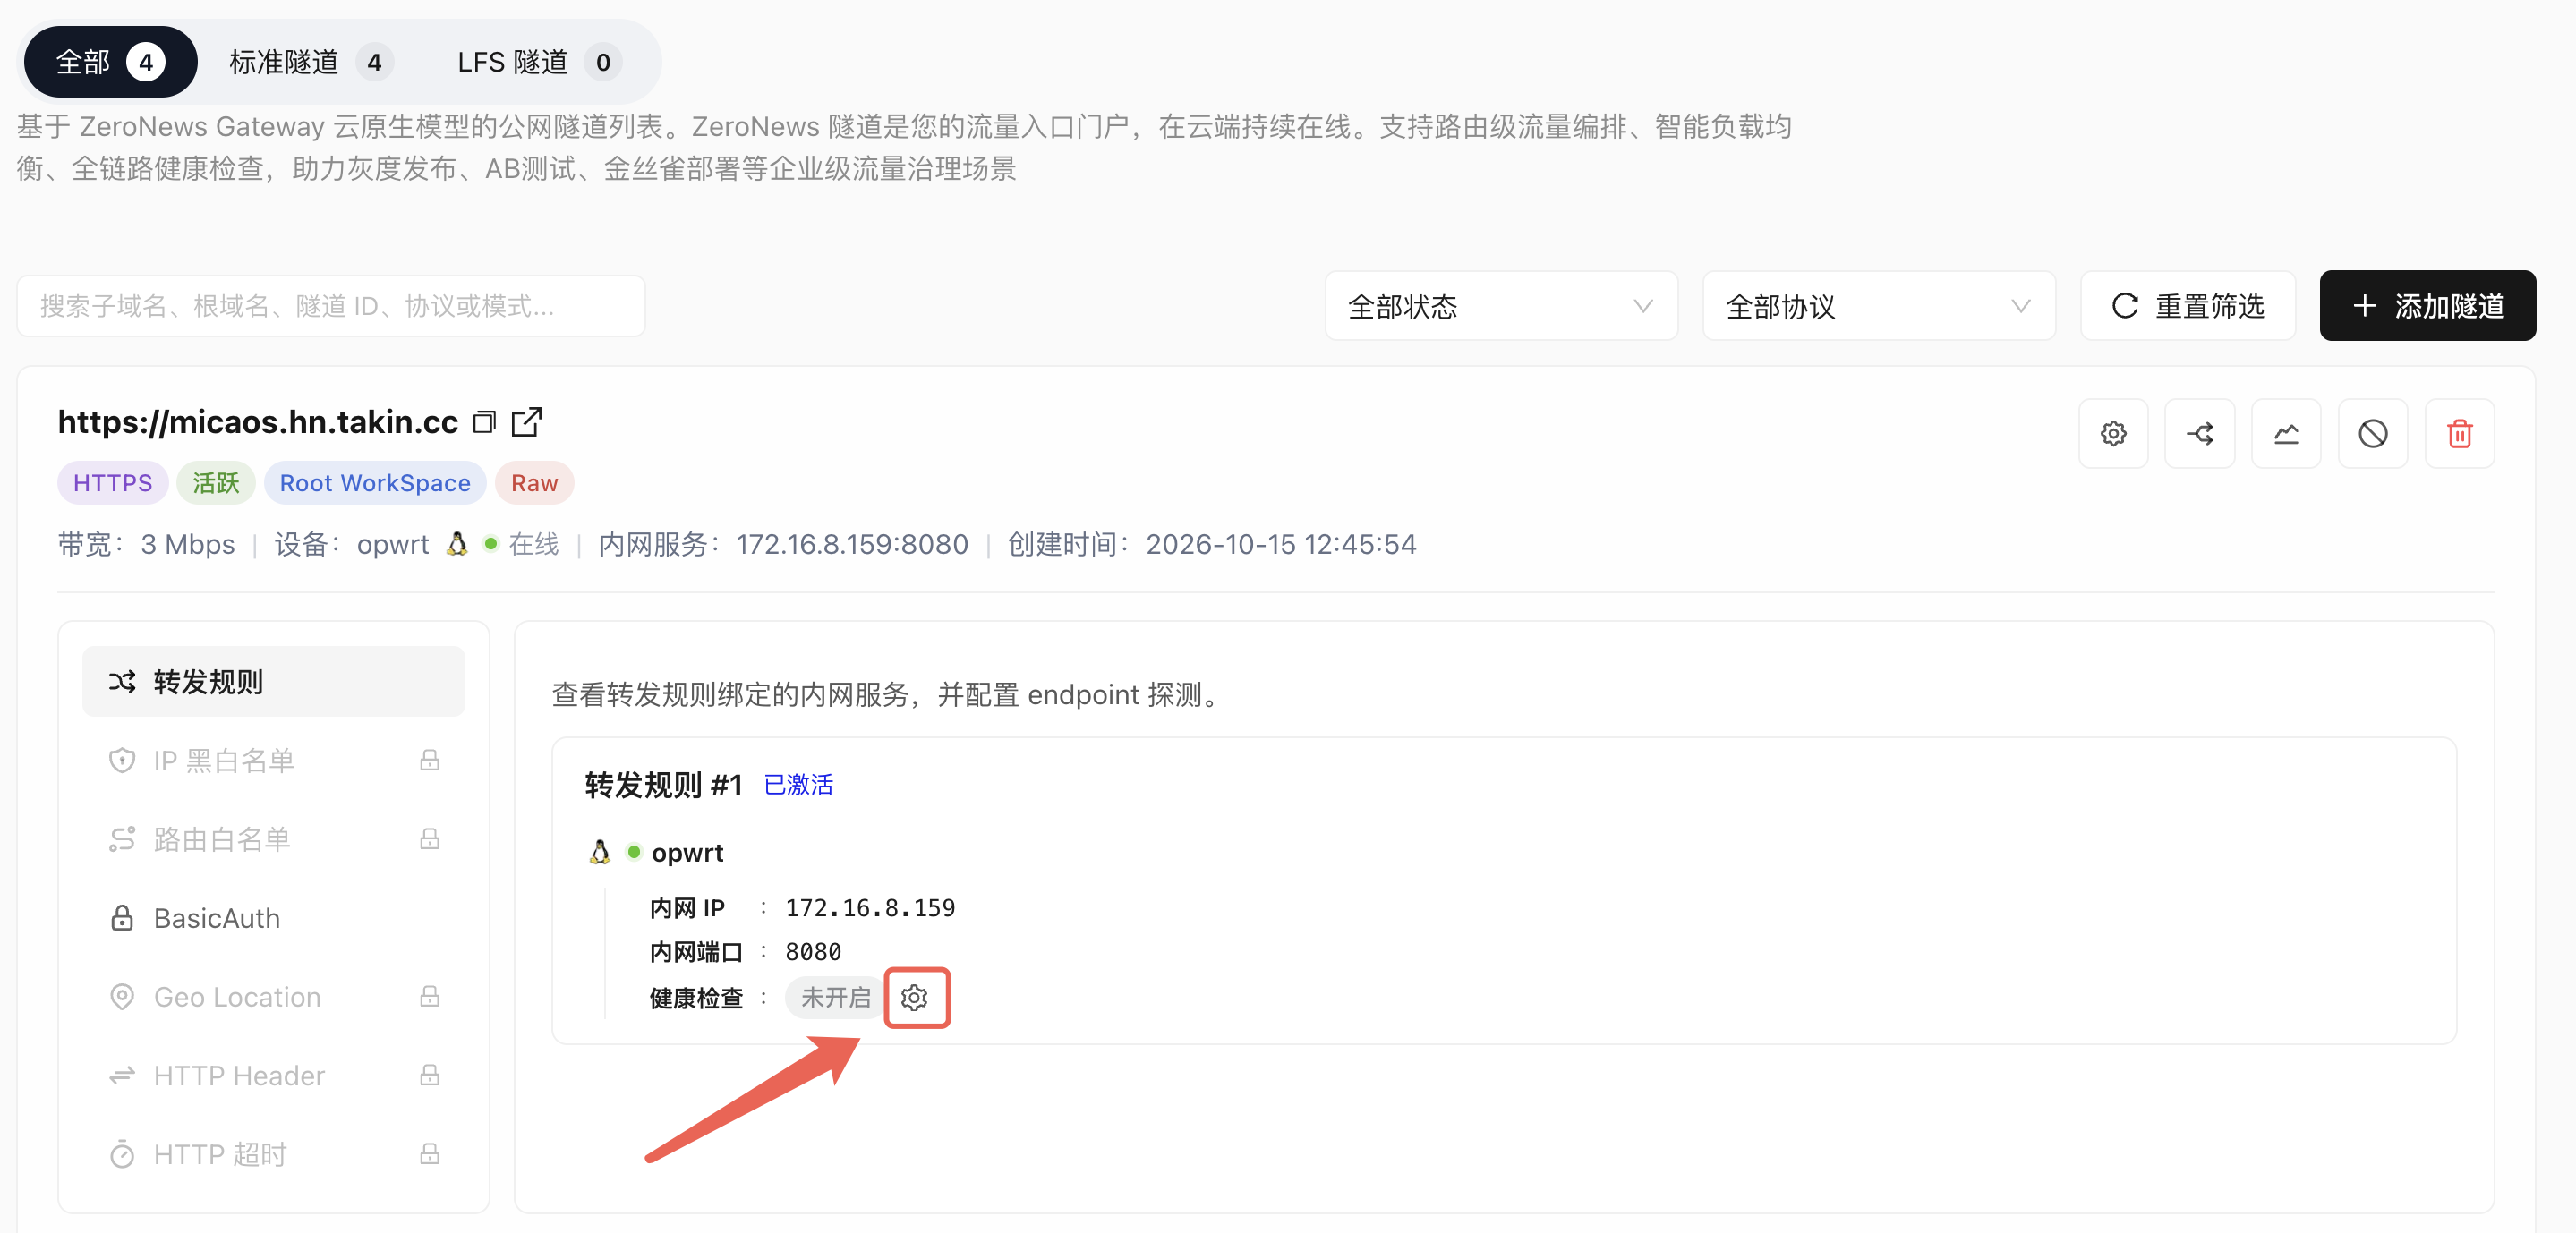
进入「转发规则」,点击「健康检查」后的编辑图标,开始配置健康检查。
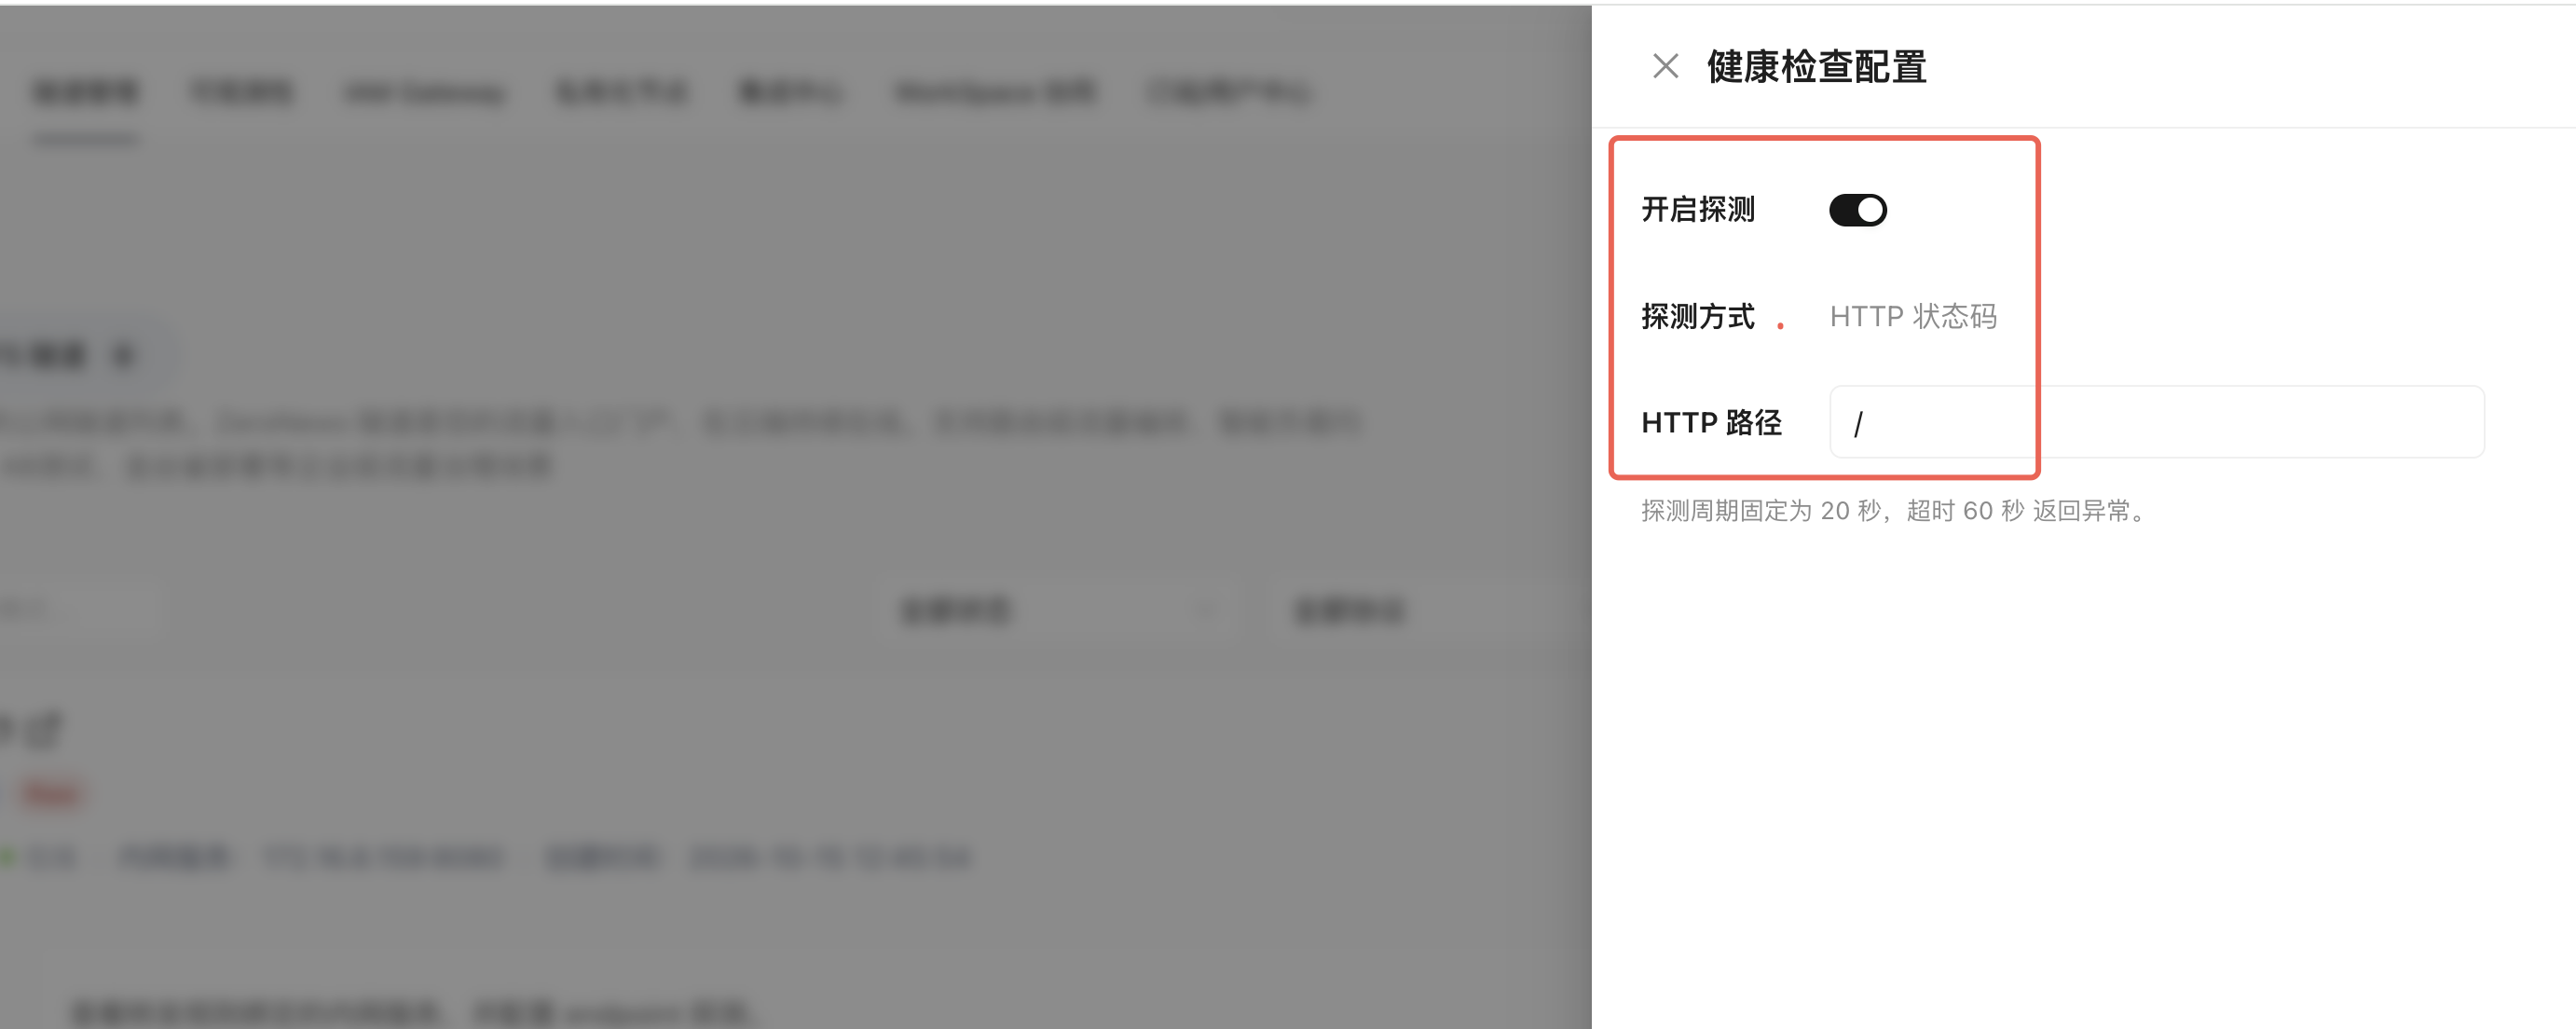
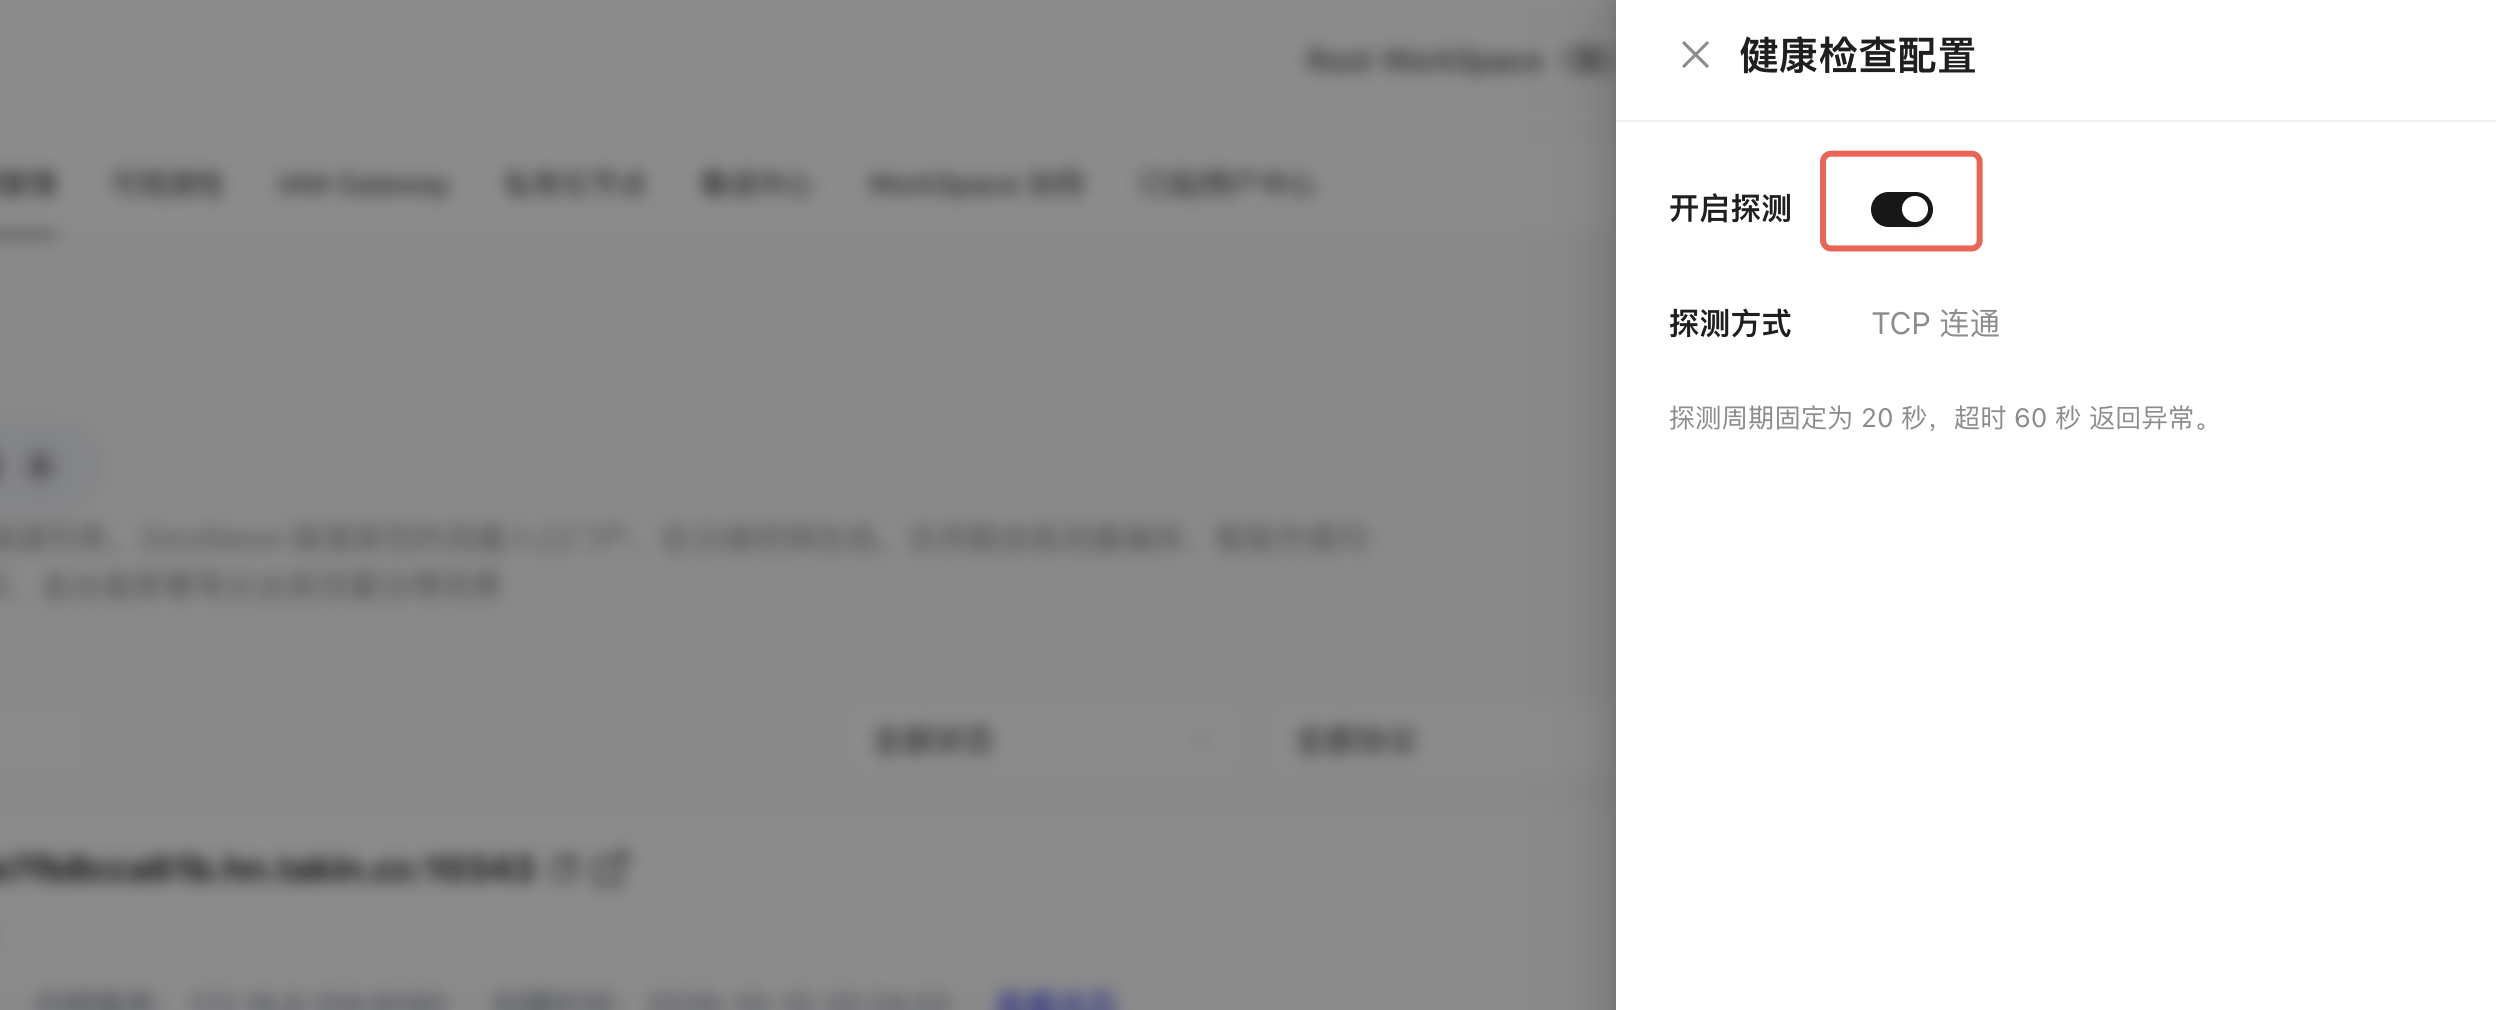
打开「开启探测」开关,配置一个可访问的 HTTP URL 探测路径(默认为 /,按实际路径填写,例如 /health)。
 配置完成后等待片刻,页面会显示内网应用状态:显示「正常」说明内网服务正常,显示「异常」则说明内网服务处于异常状态。
- TCP 隧道:开启端口连通探测
TCP 隧道的应用探测只需开启探测开关,无需配置 URL。配置完成后等待片刻,同样在页面查看内网应用的正常 / 异常状态。

配置告警通知:异常第一时间推送
在「可观测性 → 告警通知」中,先创建通知对象,添加已配置好的企微或飞书 Webhook 通知地址。
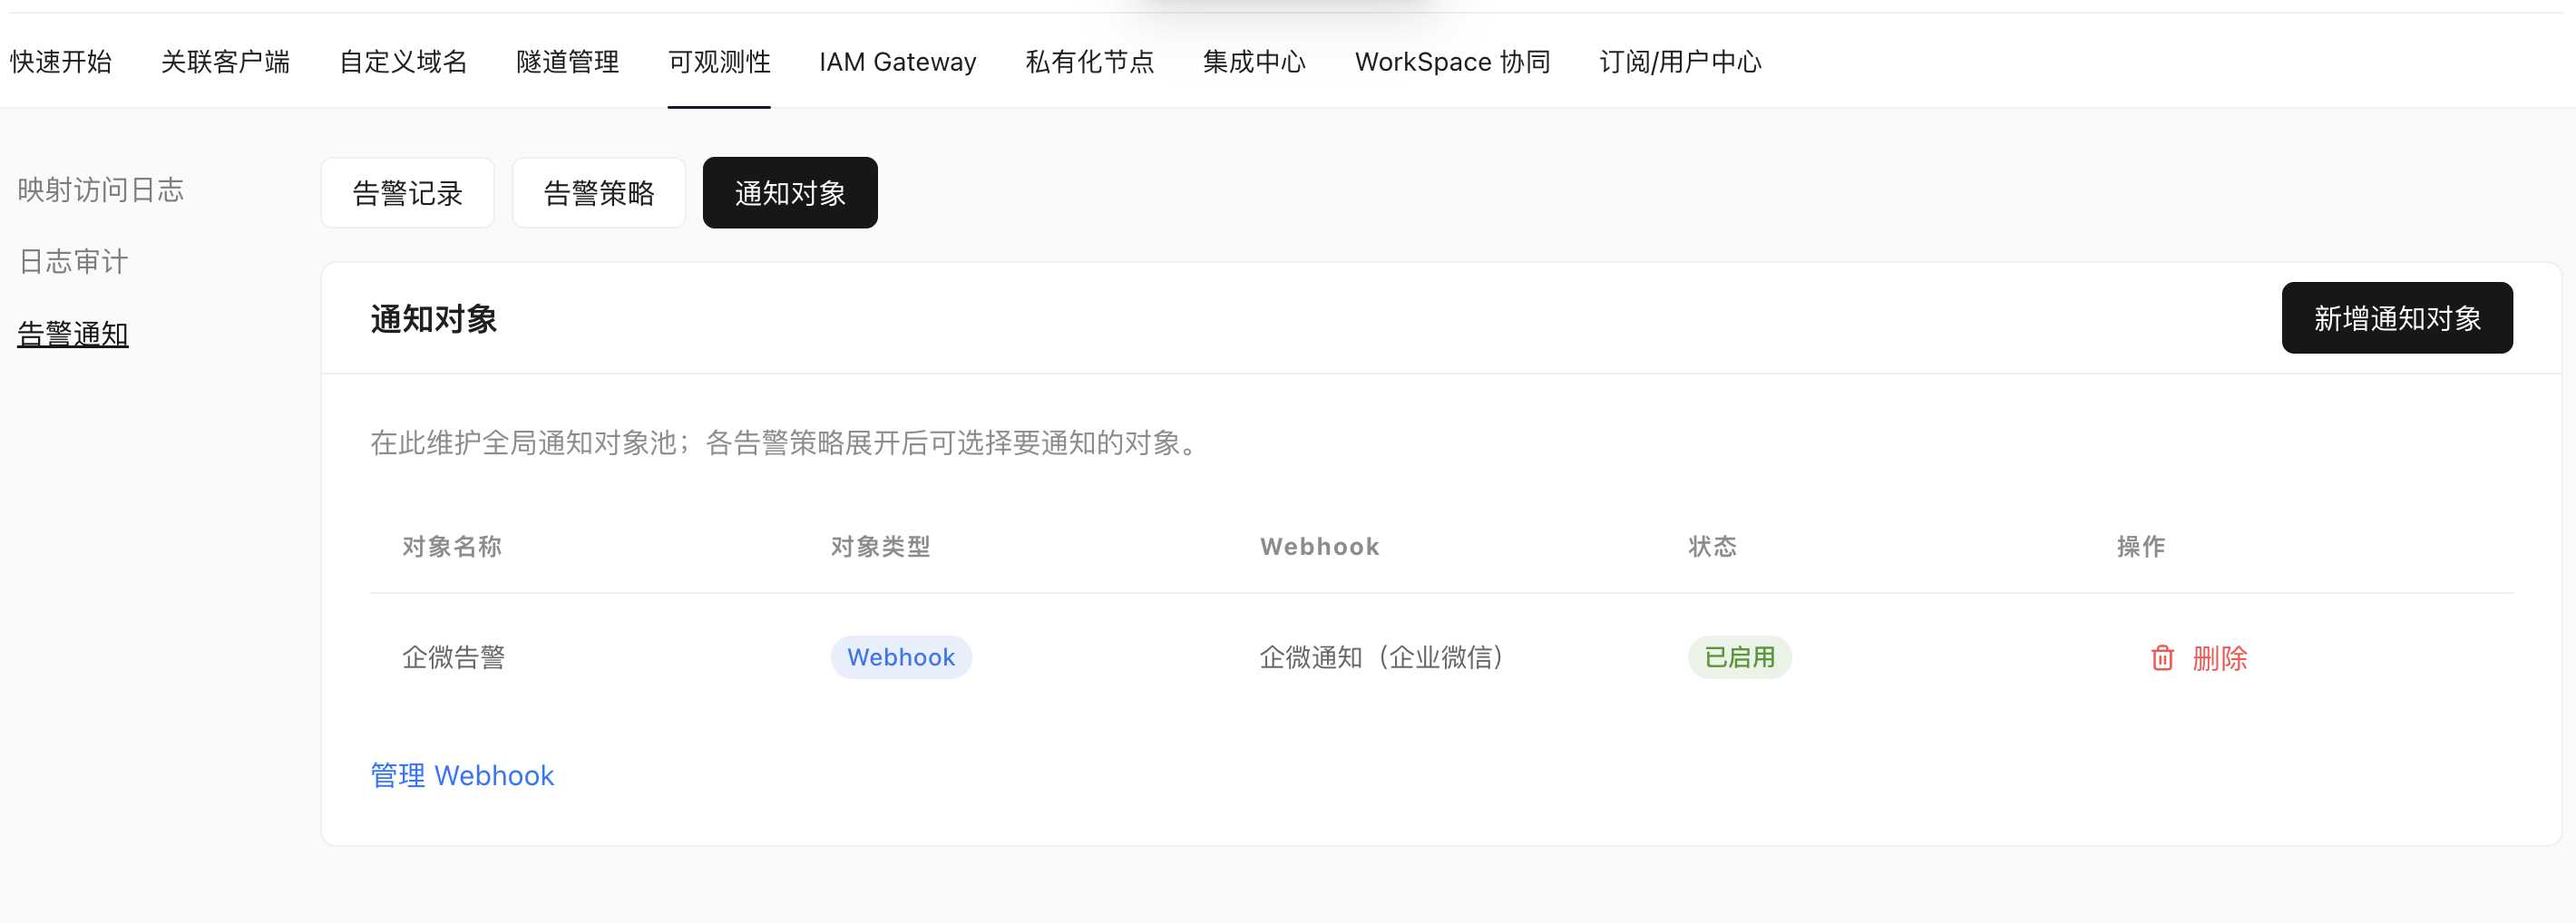
再到「告警策略」中,开启「隧道应用异常告警」即可。

当内网应用异常时,管理员会在企微(或飞书、钉钉)收到对应的告警推送。

ZeroNews 隧道应用探测解决的,是内网穿透里"内网应用可用性状态不可知"的问题:通过秒级周期性探测及时发现异常,并在异常第一时间通知负责人,把"等用户报障"改成"系统先告警、再精准排查"。
让公网隧道入口不只是"能访问",更做到应用状态可见、故障可感知——这才是内网穿透之后,最后一跳应该被盯住的地方。